Le 6 octobre 2026, Mistral a publié une préversion de Mistral Large 4, son plus gros modèle à ce jour. Officieusement ML4, et selon Mistral lui-même, très officiellement « le Chonk ». L’annonce s’accompagne d’une vingtaine de graphiques de benchmarks. Nous les avons tous lus et gardé ce qui compte quand on dirige une entreprise plutôt qu’un laboratoire d’IA.
En bref :
- ML4 est le meilleur modèle à poids ouverts conçu hors de Chine, pas le meilleur modèle ouvert tout court.
- Il se distingue sur le juridique, la résistance à la manipulation et la localisation de détails dans les images.
- En automatisation métier, il est au niveau des meilleurs modèles ouverts. En finance, il reste derrière les leaders.
- C’est une préversion. Mistral s’attend à ce que les scores progressent avant la publication des poids, fin octobre.
Ce que Mistral a publié
ML4 compte 1 000 milliards de paramètres, dont 49 milliards actifs pour chaque réponse. Il lit le texte et les images, accepte jusqu’à 1 million de tokens de contexte (environ 750 000 mots) et a été entraîné sur plus de 160 langues, dont toutes les langues officielles de l’UE. Les poids seront ouverts.
Deux détails comptent plus que la taille. D’abord, il a été entraîné et il tourne en Europe, sur des puces Nvidia dans les centres de données de Mistral, avec un déploiement européen opéré « sous droit européen ». C’est la réponse à la question de la juridiction de notre guide de l’IA souveraine. Ensuite, il coûte plus cher que Large 3 : 1,36 $ par million de tokens lus et 4,18 $ écrits au prix catalogue, actuellement remisé de moitié. Pour une réponse de chatbot classique, cela reste une fraction de centime.
Les benchmarks
Un benchmark est une série fixe de tâches, notée de la même façon pour chaque modèle. Voici les sept qui correspondent à du vrai travail d’entreprise, chacun face au meilleur rival du graphique de Mistral. La plupart ont été mesurés par des évaluateurs externes (Artificial Analysis et Vals.ai).
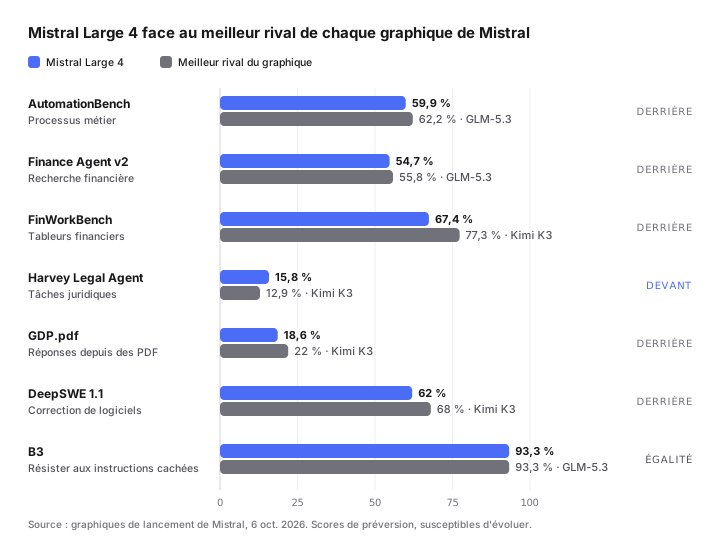
ML4 gagne une seule de ces sept épreuves et fait jeu égal sur une autre. GLM-5.3 et Kimi K3, deux modèles chinois à poids ouverts, le battent sur des graphiques que Mistral a choisi de publier. C’est à son crédit de les avoir montrés. Mais le « meilleur modèle ouvert » appelle la précision que Mistral emploie lui-même : « développé aux États-Unis ou en Europe ».
Ce que chaque résultat veut dire en pratique :
- Automatisation métier. AutomationBench enchaîne 657 processus entre Gmail, Sheets, Slack et Salesforce, proche de ce que nous construisons en automatisation email et avec TicketFlow. ML4 obtient 59,9 %, dans la même fourchette que les meilleurs modèles ouverts. Le précédent modèle polyvalent de Mistral obtenait 6,3 %. Un modèle européen n’est plus l’option faible ici.
- Juridique et finance. ML4 devance tous les modèles ouverts sur le benchmark juridique de Harvey (15,8 %, près de trois fois GPT-6 Astra). Un score aussi bas montre la difficulté du test : aucun modèle ne fait le travail d’un avocat sans supervision. En finance, il est à environ un point du leader sur un test, et dix points derrière Kimi K3 sur les tableurs.
- Documents et images. Il devance de peu GPT-6 Astra pour localiser des objets dans une image chargée, et lit les PDF complexes mieux que la plupart des rivaux présentés, Kimi K3 faisant mieux. Utile pour les factures, bons de livraison et plans techniques.
- Résistance à la manipulation. ML4 résiste à 93,3 % des attaques visant à détourner un agent IA, comme des instructions cachées dans une page web ou un document, à égalité en tête. Pour tout assistant qui lit du contenu extérieur et peut agir, c’est le chiffre à surveiller. Nous expliquons pourquoi dans connecter l’IA à vos outils.
- Code. Bon, pas premier. Kimi K3 est devant, et selon VentureBeat les meilleurs modèles fermés tournent autour de 74 % au classement public, contre 62 % pour ML4.
Quelle confiance accorder à ces chiffres
- Il est encore en entraînement. Mistral attend des « améliorations importantes et rapides ». Les scores vont bouger.
- Mistral a choisi les graphiques. Les leaders fermés apparaissent surtout là où ML4 les bat ou là où ils ont refusé la tâche.
- Un benchmark n’est pas votre activité. Un modèle en tête d’un test juridique peut échouer sur vos contrats, dans votre langue. Le test qui compte, ce sont cinquante de vos vrais cas : c’est le rôle d’une preuve de concept. Nous détaillons comment mesurer cela dans une IA digne de confiance.
Ce que cela change pour votre entreprise
Jusqu’ici, une entreprise qui voulait un modèle ouvert de premier plan, exploitable par elle-même, finissait le plus souvent avec un modèle chinois, plus difficile à justifier auprès d’un responsable conformité. ML4 donne cette option à l’Europe. Une fois les poids publiés, et sous réserve d’une licence que Mistral n’a pas encore détaillée, il pourra tourner sur la plateforme de Mistral, sur un cloud européen ou dans un centre de données de votre choix. Pas dans vos bureaux en revanche : mille milliards de paramètres demandent un serveur doté de plusieurs GPU haut de gamme.
Chaque assistant Flowful tourne sur Vectoria, qui n’est lié à aucun modèle, et la plupart de nos packages fonctionnent déjà avec les modèles Mistral. Essayer ML4 est un changement de configuration, pas un projet. Les premiers candidats sont le Chatbot interne, qui lit contrats et procédures, et le Chatbot web, qui lit ce que vos visiteurs lui envoient. La façon dont nous traitons vos données, quel que soit le modèle, est décrite sur notre page sécurité.
Ne changez pas de modèle sur la foi d’une annonce. Dites-nous quelles tâches vous confieriez à un assistant, et nous vous dirons si ML4 est le bon modèle pour elles, ou si un modèle plus petit fait le travail pour moins cher.
Vérifié le 6 octobre 2026, jour de la préversion. Les chiffres viennent des documents de lancement de Mistral sauf autre source indiquée en lien.