Op 6 oktober 2026 bracht Mistral een preview uit van Mistral Large 4, zijn grootste model tot nu toe. Onofficieel heet het ML4, en volgens Mistral zelf heel officieel “le Chonk”. De aankondiging bevat een twintigtal benchmarkgrafieken. We lazen ze allemaal en hielden over wat telt als u een bedrijf leidt in plaats van een AI-lab.
In het kort:
- ML4 is het sterkste open-weight model dat buiten China is gebouwd, niet het sterkste open model overall.
- Het blinkt uit in juridisch werk, weerstand tegen manipulatie en het lokaliseren van details in afbeeldingen.
- Voor bedrijfsautomatisering zit het op het niveau van de beste open modellen. In financiën blijft het achter de leiders.
- Het is een preview. Mistral verwacht dat de scores nog stijgen voor de weights eind oktober verschijnen.
Wat Mistral uitbracht
ML4 heeft 1.000 miljard parameters, waarvan 49 miljard actief per antwoord. Het leest tekst en afbeeldingen, verwerkt tot 1 miljoen tokens context (ongeveer 750.000 woorden) en is getraind op meer dan 160 talen, waaronder elke officiële EU-taal. De weights worden open.
Twee details tellen meer dan de grootte. Ten eerste is het in Europa getraind en draait het in Europa, op Nvidia-chips in Mistrals eigen datacenters, met een Europese uitrol “onder Europees recht”. Dat beantwoordt de jurisdictievraag uit onze gids over soevereine AI. Ten tweede is het duurder dan Large 3: $ 1,36 per miljoen gelezen tokens en $ 4,18 geschreven tegen catalogusprijs, momenteel met de helft korting. Voor een gewoon chatbotantwoord blijft dat een fractie van een cent.
De benchmarks
Een benchmark is een vaste reeks taken, voor elk model op dezelfde manier beoordeeld. Hieronder de zeven die overeenkomen met echt bedrijfswerk, telkens tegenover de beste rivaal op Mistrals eigen grafiek. De meeste zijn gemeten door externe beoordelaars (Artificial Analysis en Vals.ai).
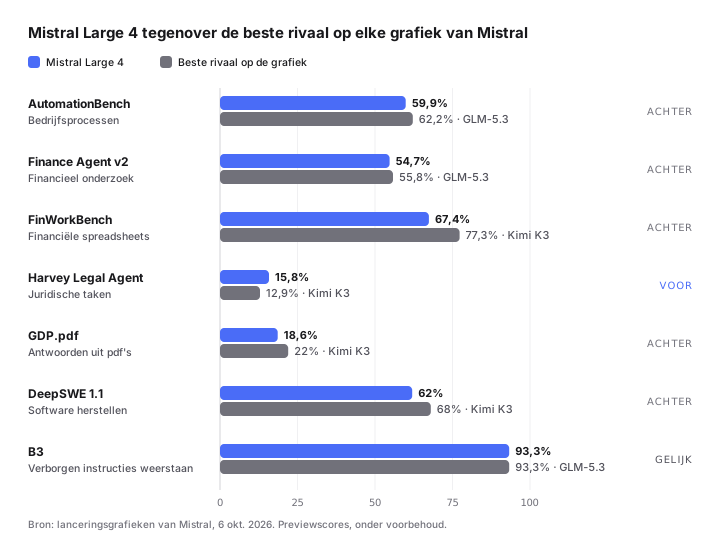
ML4 wint één van deze zeven en speelt op een andere gelijk. GLM-5.3 en Kimi K3, twee Chinese open-weight modellen, verslaan het op grafieken die Mistral zelf koos. Dat siert Mistral. Maar het “beste open model” vraagt de nuance die Mistral zelf gebruikt: “ontwikkeld in de VS of Europa”.
Wat elk resultaat in de praktijk betekent:
- Bedrijfsautomatisering. AutomationBench doorloopt 657 processen in Gmail, Sheets, Slack en Salesforce, dicht bij wat wij bouwen met e-mailautomatisering en TicketFlow. ML4 haalt 59,9%, in dezelfde klasse als de beste open modellen. Mistrals vorige allround model haalde 6,3%. Een Europees model is hier niet langer de zwakke keuze.
- Juridisch en financieel. ML4 verslaat elk open model op de juridische benchmark van Harvey (15,8%, bijna drie keer GPT-6 Astra). De lage score toont hoe zwaar de test is: geen enkel model doet het werk van een advocaat zonder toezicht. In financiën zit het op één test op ongeveer een punt van de leider, en op spreadsheetwerk tien punten achter Kimi K3.
- Documenten en afbeeldingen. Het doet net iets beter dan GPT-6 Astra in het lokaliseren van objecten in drukke afbeeldingen, en leest complexe pdf’s beter dan de meeste getoonde rivalen, al doet Kimi K3 het beter. Nuttig voor facturen, leverbonnen en technische tekeningen.
- Weerstand tegen manipulatie. ML4 weerstaat 93,3% van de aanvallen die een AI-agent proberen te kapen, zoals instructies verstopt in een webpagina of document, gedeeld eerste. Voor elke assistent die externe inhoud leest en kan handelen, is dit het cijfer om te volgen. Waarom, leest u in AI koppelen aan uw bedrijfstools.
- Programmeren. Goed, niet eerste. Kimi K3 staat voor, en volgens VentureBeat scoren de beste gesloten modellen rond 74% op de publieke ranglijst, tegen 62% voor ML4.
Hoeveel vertrouwen verdienen deze cijfers
- Het wordt nog getraind. Mistral verwacht “grote en snelle verbeteringen”. De scores gaan bewegen.
- Mistral koos de grafieken. De gesloten leiders verschijnen vooral waar ML4 ze verslaat of waar ze de taak weigerden.
- Een benchmark is niet uw werk. Een model dat bovenaan een juridische test staat, kan falen op uw contracten, in uw taal. De test die telt, zijn vijftig van uw echte gevallen: daarvoor dient een proof of concept. Hoe u dat meet, leest u in AI die u kunt vertrouwen.
Wat het betekent voor uw bedrijf
Tot nu toe kwam een bedrijf dat een open topmodel zelf wilde draaien meestal uit bij een Chinees model, moeilijker uit te leggen aan een compliance officer. ML4 geeft Europa die optie. Zodra de weights beschikbaar zijn, en onder voorbehoud van een licentie die Mistral nog niet heeft toegelicht, kan het draaien op het platform van Mistral, op een Europese cloud of in een datacenter naar keuze. Niet op kantoor: duizend miljard parameters vragen een server met meerdere high-end GPU’s.
Elke Flowful-assistent draait op Vectoria, dat aan geen enkel model vastzit, en de meeste van onze pakketten werken al met Mistral-modellen. ML4 proberen is een configuratiewijziging, geen project. De voor de hand liggende eerste kandidaten zijn de Interne chatbot, die contracten en procedures leest, en de Webchatbot, die leest wat uw bezoekers sturen. Hoe wij met uw data omgaan, welk model u ook kiest, staat op onze beveiligingspagina.
Wissel niet van model door een aankondiging. Vertel ons welke taken u aan een assistent zou toevertrouwen, en wij zeggen u of ML4 daarvoor het juiste model is, of dat een kleiner model het werk goedkoper doet.
Gecontroleerd op 6 oktober 2026, de dag van de preview. Cijfers komen uit het lanceringsmateriaal van Mistral, tenzij een andere bron gelinkt is.